
 下一版


 |
 |
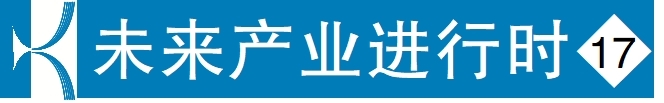
| 图①: 机器人在超市模拟环境下分拣货物进行训练。 |
 |
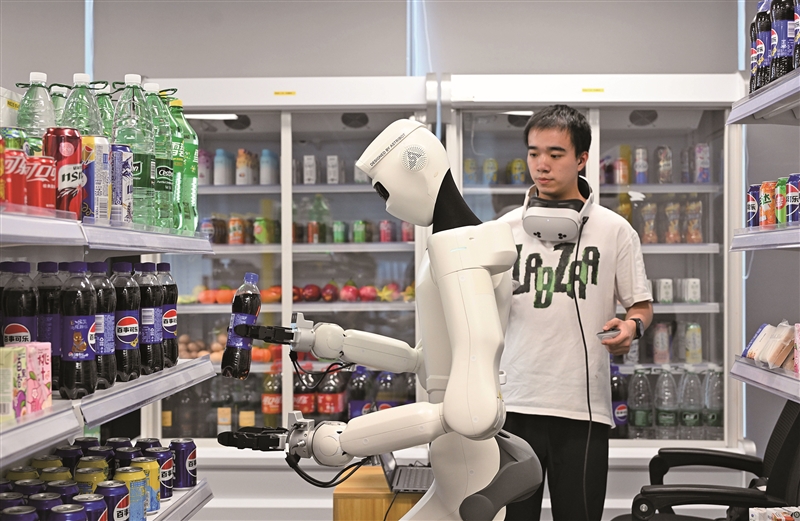
| 图②: 机器人分拣员分拣快递包裹。 |
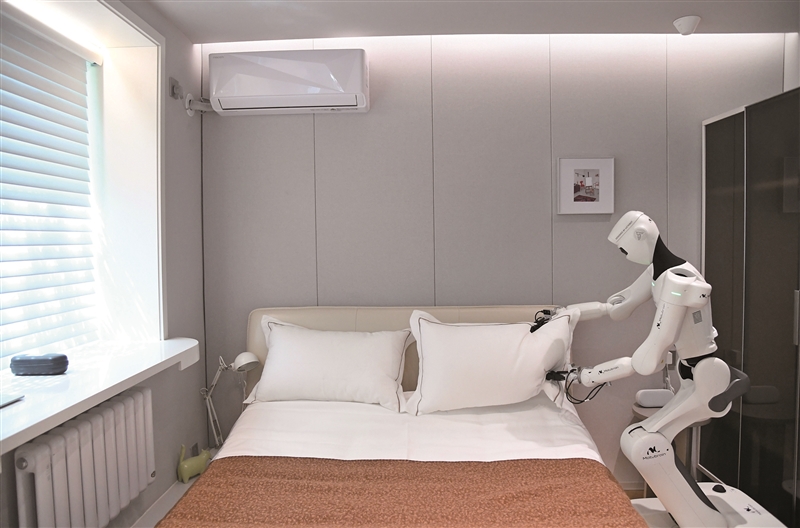 |
| 图③: 机器人在真实场景试验室进行整理家务训练。新华社发 |
今年下半年以来,机器人进车间“干活”已成常态,但生硬的动作和时不时的“卡壳”行为,很难让人对它们抱有多高的期待。究其原因,问题并不在于机器人的钢铁骨架不够灵动,也不在于其算法不够聪明,而是它们缺少足够多、足够好的“物理经验”——高质量具身智能数据。
11月10日,全国数据标准化技术委员会成立具身智能数据标准起草工作组,目标直指真机采集数据、人类演示数据等标准预研——为了让机器人能“上班”,数据这道门槛终于要被认真“丈量”了。
机器人的成长“教材”,跟大模型不一样
我们熟悉的大语言模型,基本上是由网络上浩如烟海的文字、图片“喂”大的,而具身智能成长所需的“教材”完全不同:机器人要学的是动态的、有先后顺序、有因果关系的物理过程——抓起鸡蛋该用多大劲、拧螺丝需要什么角度。这些关于力度、材质、平衡的经验网络上没有,必须在真实交互中“试”出来。
国家数据专家咨询委员会委员张向宏在2026年世界互联网大会乌镇峰会上明确表示,包括通用大模型、行业大模型、智能体、世界模型、具身智能在内的五类人工智能对数据的需求不一样,高质量数据已成为人工智能发展的关键瓶颈。
赛智产业研究院院长赵刚说,具身智能所需要的高质量数据,绝不是一段机器人跳舞的漂亮视频,而是完整记录“看到→想到→做到→反馈”全过程的数据包:画面、声音、力度感和机器人做出的动作,要按时间顺序严丝合缝地绑在一起。“当然,这类数据也并非越多越好。机器人需要的不是‘看过一万次同样的抓取’,而是‘经历过足够多样、足够有信息量的物理瞬间’。”
真机数据是“金标准”,也是“吞金兽”
高质量具身智能数据,到底从何而来?
目前最靠谱的来源是真机遥操作:真人戴着设备远程操控机器人,把它的一举一动完整录下来。不过代价相当惊人,有从业者算过一笔直观的账:30秒真机采集成本10-15元;攒1小时要花费1000元左右;想凑够20万小时,得投入两个亿。
仿真数据当然也是不错的选择,成本能压到真机的5%,还能无限生成、自动打标签、快速换场景。11月5日,物理AI仿真与数据基础设施企业光轮智能与宇树科技达成战略合作——光轮智能将结合宇树机器人的自由度、负载能力与末端执行器特性,提供人类视频数据与仿真合成数据。
当然,仿真和真实间还隔着一道“次元壁”:仿真中练得再溜的数据到真机上,也可能因传感器有点飘、物体会轻微变形等“不完美细节”翻车。
“仿真对具身智能的价值,不只是生成数据,更是要提供模型后训练的强化学习环境和可重复的评测环境。”光轮智能产品策略总监何仲解释,仿真不是要完美复刻现实,而是要建设成一个有真实测量和工程知识支撑、能用于后训练和评测,并通过专家和真机反馈持续校准的环境,从而逐步缩小仿真到真机间的“鸿沟”。
目前行业的共识是:真机数据保质量、保落地,仿真数据补规模、补少见场景。
标准需要的答案,是“数据能不能用”
不少人好奇,具身智能的数据缺口到底有多大?
一个被反复引用的数字是:国内真实物理交互场景的合规数据约50万小时,而机器人商业化落地需要数千万小时,缺口超过99%。
巨大的供需缺口,催生出大量专业数据采集基地。天眼查最新数据显示,我国名称或经营范围涉“具身智能”的相关企业达812家,为训练场建设及机器人真实场景数据采集、应用验证提供了更广的产业基础;中国信息通信研究院数据显示,全国已建成超70家具身智能训练场,另有46家正在建设或规划中;多家头部企业更是将年度数据采集目标,锁定在百万小时级别。
只是,数量暴涨并不等于质量达标。各家数据格式、标注标准、采集质量各不相同,更易形成大量封闭的“数据孤岛”。
11月1日正式实施的《人工智能 关键基础技术 具身智能数据集质量要求及评价方法》,正在从完整性、真实性、安全性等八个维度统一规范数据质量;新成立的具身智能数据标准起草工作组,则是把标准延伸到更前端、更底层的环节——真机采集数据怎么记、人类演示数据怎么用、上下文协议怎么定,让数据从诞生起就带有“可比较、可流通、可训练”基因。
赵刚认为,未来决定机器人能否“上班”的关键,不再是谁家的演示视频更炫酷,而是谁家的数据真正包含真实世界的“物理知识”。
==============================
延伸阅读
数据泛化:让机器人学会“举一反三”
同样靠数据学习,通用大模型越聊越灵活,机器人干活却常显死板。二者的核心差距,其实在数据泛化能力。
数据泛化,是指AI用已有的数据学到规律,应对从没见过的新场景。通俗说,就是让机器人拥有“举一反三”的能力。
现阶段,工业机器人大多是“专项选手”:在固定流水线上练千次,能精准完成同一动作。物品外形、摆放角度一变,或光线、摩擦力稍有不同,工业机器人就容易失误。原因就是训练数据太单一,没掌握物理世界通用规律。
具备出色数据泛化能力的机器人,突破了这一局限。它们得到的高质量具身智能数据,不只记录“怎么做”,还包含重力、摩擦、形变等通用物理逻辑。机器人学会的不是“捏紧这个杯子”,而是“根据物体软硬、轻重调整力度”,自主适配应用需求。
统一具身智能数据标准,目标也囊括了机器人的数据泛化能力,让它们可以整合多元场景经验,灵活应对多变的现实世界。